Boty AI przeciążają stronę: jak rozpoznać je w logach i ograniczyć bez znikania z ChatGPT
- Typowe objawy
- Sklep zwalnia lub zwraca błąd 503 bez wzrostu sprzedaży, hosting pisze o przekroczeniu limitów
- Najczęstsza przyczyna
- Boty chodzące po koszyku i filtrach produktów, czyli adresach, których nie obsługuje cache
- Czas naprawy
- Doraźnie godzina, porządnie kilka godzin z obserwacją logów
- Czy zrobisz to sam?
- Robots.txt tak. Reguły serwera i CDN tylko z kopią i dostępem do logów
Szybka odpowiedź
Pobierz z panelu hostingu log dostępu i policz żądania według nazwy bota. Boty wyszukiwarek (Googlebot, Bingbot) i wyszukiwania w czatach (OAI-SearchBot, Claude-SearchBot, PerplexityBot) zostaw, bo dzięki nim klienci Cię znajdują. Boty treningowe (np. GPTBot, ClaudeBot, CCBot) możesz zablokować w robots.txt bez wpływu na wyszukiwanie. Przeciążenie usuń regułą na serwerze lub w CDN, która na adresach koszyka i filtrów odpowiada kodem 429, czyli „zwolnij, spróbuj później”, zamiast blokować wszystko.
Bot (crawler) to program, który automatycznie odwiedza strony i pobiera ich treść. Od lat robią to wyszukiwarki. Od niedawna robią to także firmy budujące modele językowe i czaty: jedne boty zbierają teksty do trenowania modeli, inne szukają odpowiedzi dla użytkownika czatu w czasie rzeczywistym.
Dla zwykłej strony firmowej to zwykle niezauważalne. Dla sklepu WooCommerce na współdzielonym hostingu potrafi być różnicą między działającą kasą a błędem 503. Poniżej pokazuję, jak sprawdzić, czy to Twój problem, i jak go rozwiązać bez wycinania się z Google i z czatów AI.
Co to znaczy dla Twojego sklepu
Problem nie polega na tym, że bot czyta Twoje strony produktów. Polega na tym, które adresy odwiedza i jak często:
- Adresy dodawania do koszyka. Przy każdym produkcie na liście jest przycisk, za którym stoi adres w rodzaju
/sklep/?add-to-cart=13. Bot, który „klika” każdy taki link, zmusza sklep do pełnej pracy: PHP, baza danych, nowy koszyk. - Filtry i sortowanie. Każda kombinacja koloru, ceny i sortowania to dla bota nowy adres. Kategoria z dziesięcioma filtrami daje tysiące adresów, z których każdy trzeba wygenerować od zera.
- Limity hostingu. Hostingi współdzielone limitują procesor i liczbę jednoczesnych procesów PHP. Gdy boty je wyczerpią, prawdziwy klient dostaje błąd albo czeka kilkanaście sekund.
Skala bywa duża. Firma hostingowa Kinsta opisała w swoich danych z 2026 roku jednego bota AI, który w ciągu doby wysłał 3,75 mln żądań do adresów „dodaj do koszyka”; według Kinsty był to bot przedstawiający się jako ClaudeBot, a w tym samym zestawieniu pojawiły się też BLEXBot, GPTBot i Googlebot. Dane te przytacza Imunify360, producent popularnego na hostingach oprogramowania zabezpieczającego, w zapowiedzi ograniczania botów AI z 23 lipca 2026. Rozsądny wniosek z obu źródeł: nie blokować na ślepo, tylko ograniczać tam, gdzie bot generuje koszt.
Trzy rodzaje botów AI i co z nimi zrobić
Najważniejsza rzecz w tym artykule: jedna firma ma zwykle kilka botów do różnych celów. Zablokowanie bota treningowego nie usuwa Cię z wyszukiwania w czacie tej samej firmy, a zablokowanie bota wyszukiwania właśnie to robi.
- Boty treningowe zbierają treści do trenowania przyszłych modeli. Nie przyprowadzają klientów. Tu decyzja należy do Ciebie.
- Boty wyszukiwania indeksują strony, żeby czat mógł je cytować i linkować w odpowiedziach. Te przyprowadzają ruch.
- Pobieranie na żądanie to wejście na stronę, gdy użytkownik czatu poprosi o jej odczytanie. Operatorzy zastrzegają, że w tym przypadku robots.txt może nie być stosowany.
| Bot (nazwa w logu) | Do czego służy | Co zrobić |
|---|---|---|
Googlebot | Indeks Google, także przeglądy od AI | Zostaw. Nigdy nie blokuj |
bingbot | Indeks Bing, z którego korzysta Copilot | Zostaw. Nigdy nie blokuj |
Google-Extended | Tylko znacznik w robots.txt: trening Gemini i ugruntowanie odpowiedzi Gemini | Twoja decyzja; nie wpływa na wyszukiwarkę Google |
OAI-SearchBot | Wyszukiwanie w ChatGPT | Zostaw, jeśli chcesz być w ChatGPT |
GPTBot | Trening modeli OpenAI | Blokuj lub zostaw, bez wpływu na wyszukiwanie |
ChatGPT-User | Wejścia na prośbę użytkownika ChatGPT | Zostaw, ruch zwykle mały |
Claude-SearchBot | Wyszukiwanie w Claude | Zostaw, jeśli chcesz być w Claude |
ClaudeBot | Trening modeli Anthropic | Blokuj lub ogranicz przez Crawl-delay |
Claude-User | Wejścia na prośbę użytkownika Claude | Zostaw |
PerplexityBot | Wyszukiwanie Perplexity | Zostaw, ogranicz adresy dynamiczne |
meta-externalagent | Trening modeli Meta | Blokuj lub zostaw |
CCBot | Common Crawl, otwarty zbiór stron używany m.in. do trenowania modeli | Blokuj lub zostaw |
Bytespider | Bot ByteDance, opisywany jako treningowy | Ograniczaj na serwerze (patrz niżej) |
Źródła: dokumentacje botów OpenAI, Anthropic, Google, Perplexity, Meta i Common Crawl, stan na październik 2026. Dla Bytespidera nie znalazłem oficjalnej dokumentacji operatora z listą adresów IP, a administratorzy często zgłaszają, że nie zawsze stosuje się do robots.txt, dlatego przy nim polegam na regułach serwera.
Jak znaleźć boty w logach serwera
Log dostępu (access log) to plik, w którym serwer zapisuje każde żądanie: adres IP, czas, odwiedzony adres, kod odpowiedzi i nazwę przeglądarki lub bota (tzw. User-Agent). W większości paneli hostingowych pobierzesz go z sekcji z logami lub statystykami. Jeśli hosting udostępnia tylko statystyki, zwykle mają one zakładkę z listą robotów i liczbą ich wizyt, co wystarczy do pierwszej oceny.
Tak wyglądają linie logu w popularnym formacie (przykład z wygenerowanego, fikcyjnego logu; adresy IP pochodzą z zakresów zarezerwowanych do dokumentacji):
203.0.113.21 - - [27/Oct/2026:03:14:07 +0100] "GET /sklep/?add-to-cart=12 HTTP/1.1" 200 41873 "-"
  "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; ClaudeBot/1.0; +claudebot@anthropic.com)"
198.51.100.40 - - [27/Oct/2026:03:14:09 +0100] "GET /kategoria/akcesoria/?filter_kolor=czarny&min_price=10&orderby=date HTTP/1.1" 200 52310 "-"
  "Mozilla/5.0 (Linux; Android 5.0) AppleWebKit/537.36 (KHTML, like Gecko) Mobile Safari/537.36 (compatible; Bytespider; spider-feedback@bytedance.com)"
Na serwerze z dostępem SSH (albo na swoim komputerze z Linuksem lub Makiem po pobraniu pliku) policz żądania każdego bota. Pętla poniżej dla każdej nazwy liczy linie logu, w których występuje, i sortuje wynik od największego:
for b in GPTBot OAI-SearchBot ChatGPT-User ClaudeBot Claude-SearchBot Bytespider \
         meta-externalagent PerplexityBot CCBot Googlebot bingbot; do
  printf "%6d %s\n" "$(grep -c "$b" access.log)" "$b"
done | sort -rn
Wynik dla przykładowego logu z 4000 żądań z jednej doby (boty z zerem pominąłem):
  1840 ClaudeBot
   610 Bytespider
   420 GPTBot
   260 meta-externalagent
   180 Googlebot
    70 bingbot
    60 OAI-SearchBot
Druga ważna liczba: ile z tych żądań trafiło w koszyk. To polecenie wybiera tylko linie z add-to-cart= i dla każdego bota liczy, ile ich jest:
for b in ClaudeBot Bytespider GPTBot meta-externalagent Googlebot; do
  printf "%6d %s\n" "$(grep 'add-to-cart=' access.log | grep -c "$b")" "$b"
done | sort -rn
   867 ClaudeBot
   292 Bytespider
   180 GPTBot
   114 meta-externalagent
    25 Googlebot
Jeśli na Twojej liście nie ma żadnego znanego bota, a obciążenie jest, sprawdź najaktywniejsze adresy IP i nazwy przeglądarek. Pierwsze polecenie wypisuje adresy IP z największą liczbą żądań, drugie najczęstsze nazwy User-Agent:
awk '{print $1}' access.log | sort | uniq -c | sort -rn | head
awk -F'"' '{print $6}' access.log | sort | uniq -c | sort -rn | head
Setki żądań na minutę z jednego IP, który przedstawia się jako zwykły Chrome, to zwykle skaner lub scraper (program kopiujący treść), a nie klient.
Fałszywe boty: sprawdź adres IP, nie nazwę
Nazwę bota w nagłówku User-Agent każdy może wpisać dowolnie, więc złośliwe programy chętnie podszywają się pod Googlebota. Dlatego poważni operatorzy publikują listy swoich adresów IP: OpenAI (openai.com/gptbot.json, openai.com/searchbot.json), Anthropic (claude.com/crawling/bots.json), Perplexity, Common Crawl i Google. Dla Googlebota Google opisuje też sprawdzenie przez DNS. Pierwsze polecenie pyta, jaka nazwa kryje się za adresem IP, drugie sprawdza, czy ta nazwa wskazuje z powrotem na ten sam adres:
host 66.249.66.1
host crawl-66-249-66-1.googlebot.com
Prawdziwy Googlebot ma nazwę w domenie googlebot.com (lub google.com), a obie odpowiedzi muszą się zgadzać. Bot z nazwą Googlebot i adresem spoza list Google możesz bez obaw zablokować. Gotowe usługi, o których niżej, robią tę weryfikację automatycznie.
Dlaczego sklep cierpi najbardziej: cache i adresy dynamiczne
Cache stron (page cache) to zapisane gotowe wersje stron. Gdy klient lub bot otwiera produkt, serwer wysyła gotowy plik zamiast budować stronę od nowa w PHP i bazie danych. Taka odpowiedź kosztuje ułamek zasobów. Problem w tym, że koszyka, kasy, konta klienta i większości filtrowanych adresów cache nie obsługuje i obsługiwać nie powinien, bo każda taka strona jest inna dla każdego.
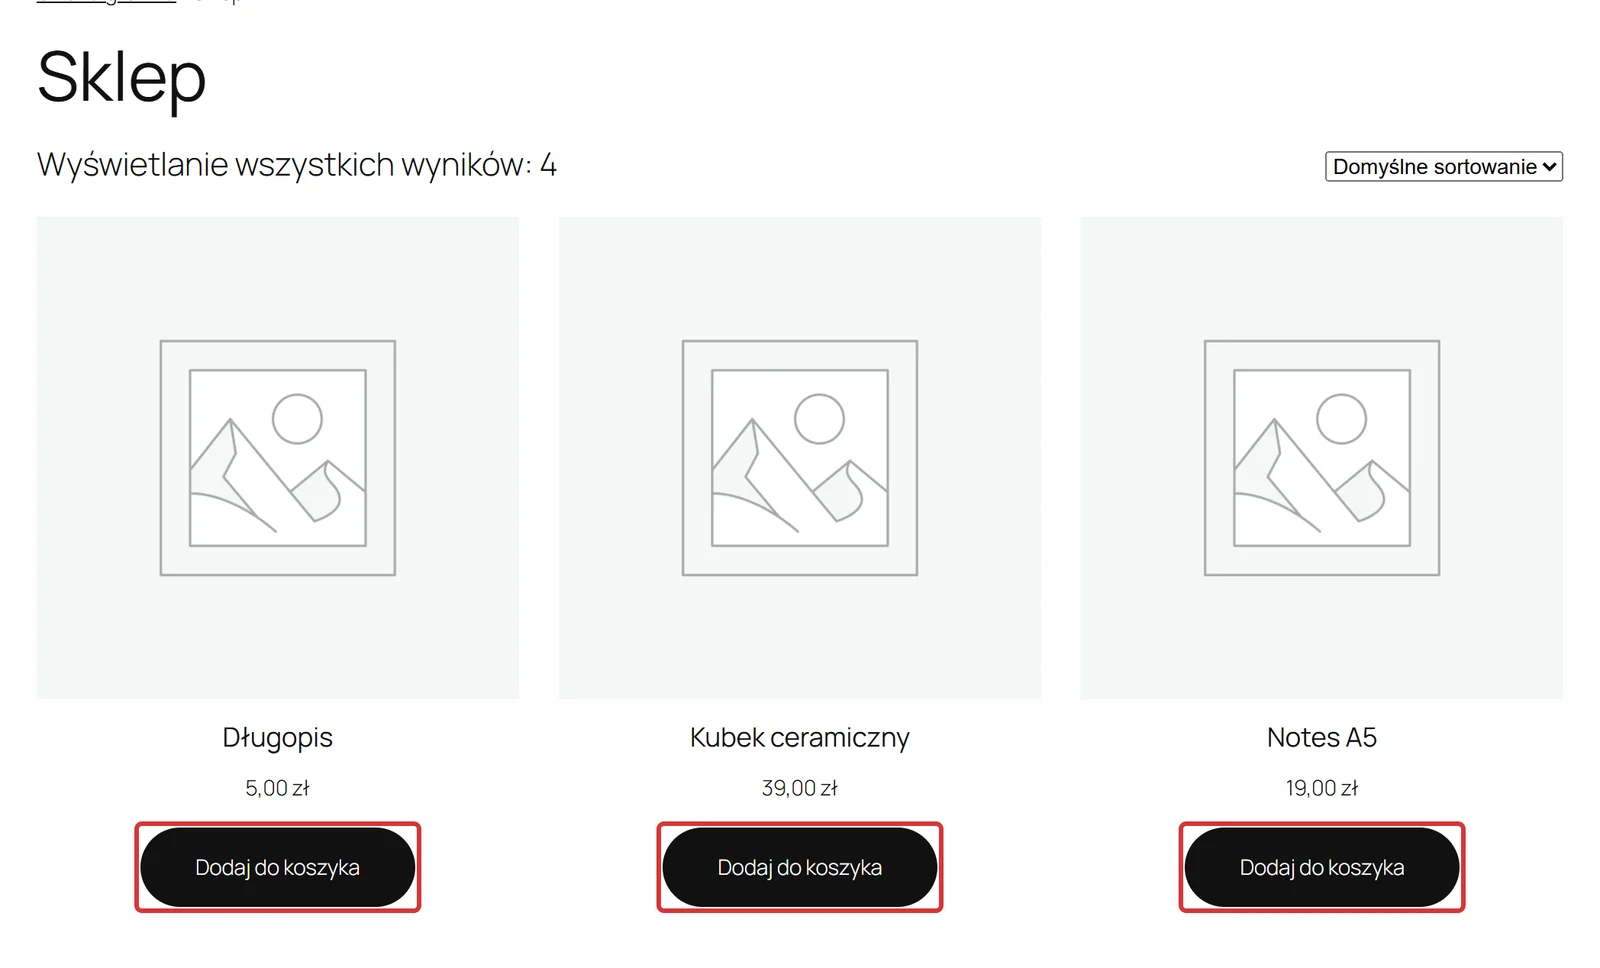
Sprawdziłem to na testowej instalacji WooCommerce 11.2.1: jedno żądanie ?add-to-cart= wysłane bez ciasteczek, tak jak robi to typowy bot, zakłada nowy koszyk, czyli nowy wiersz w tabeli sesji WooCommerce (wp_woocommerce_sessions), i dostaje odpowiedź z nagłówkiem zakazującym zapisu w cache. Tysiąc takich żądań to tysiąc wywołań PHP, tysiąc zapisów do bazy i rosnąca tabela, którą sklep potem sprząta.
Sprawdź też, czy Twój sklep w ogóle ma cache stron. WordPress pokazuje to w Narzędzia → Stan witryny (w wersji angielskiej Tools → Site Health).
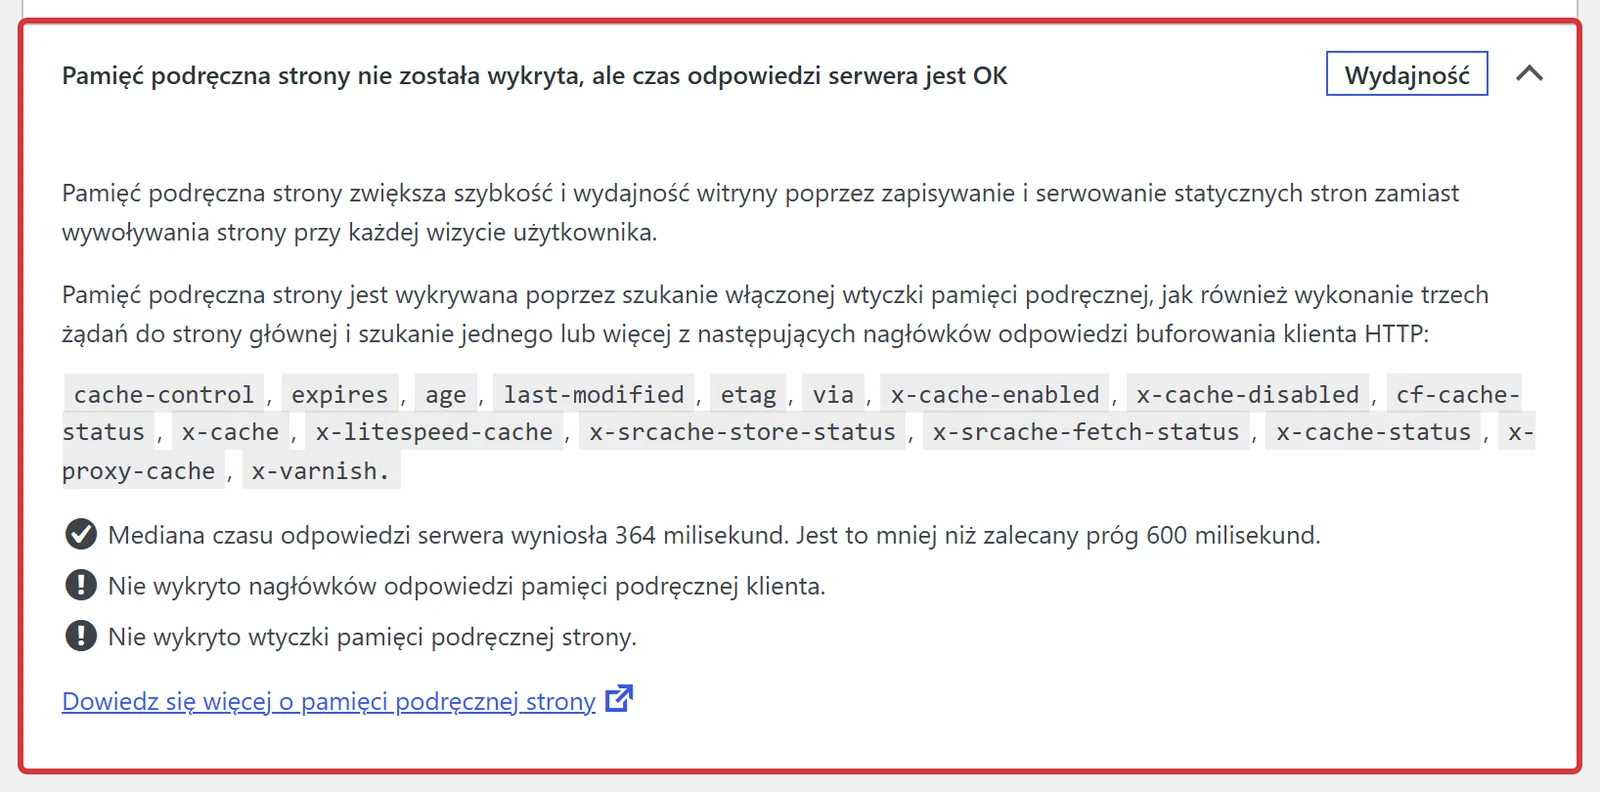
Dlatego ochrona działa warstwami. Im wcześniej zatrzymasz zbędne żądanie, tym mniej kosztuje.
Robots.txt: prośba do grzecznych botów
Robots.txt to plik tekstowy pod adresem twojadomena.pl/robots.txt, w którym piszesz botom, czego nie odwiedzać. Duzi operatorzy z tabeli deklarują, że go respektują, ale to prośba, a nie blokada. Zacznij od wyłączenia adresów, których żaden bot nie potrzebuje. Według wytycznych Google o nawigacji fasetowej blokowanie w robots.txt adresów filtrów, których nie chcesz w wynikach, to zalecany sposób oszczędzania zasobów serwera.
# wszyscy: bez koszyka, kasy, konta i filtrów
User-agent: *
Disallow: /*add-to-cart=
Disallow: /*?*filter_
Disallow: /*?*min_price=
Disallow: /*?*orderby=
Disallow: /koszyk/
Disallow: /zamowienie/
Disallow: /moje-konto/
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

# boty treningowe: bez dostępu (Twoja decyzja)
User-agent: GPTBot
User-agent: CCBot
User-agent: meta-externalagent
Disallow: /

# ClaudeBot: wolniej i bez adresów dynamicznych
User-agent: ClaudeBot
Crawl-delay: 10
Disallow: /*add-to-cart=
Disallow: /*?*filter_
Disallow: /*?*min_price=
Disallow: /*?*orderby=
Disallow: /koszyk/
Disallow: /zamowienie/
Disallow: /moje-konto/

Sitemap: https://twojadomena.pl/sitemap_index.xml
Kilka rzeczy, które łatwo przeoczyć:
- Bot wybiera jedną grupę. Jeśli ClaudeBot ma własną grupę, ignoruje tę dla wszystkich (
*). Dlatego reguły koszyka i filtrów trzeba w niej powtórzyć. Crawl-delaynie działa wszędzie. Anthropic deklaruje, że go obsługuje, Bing opisywał obsługę w swojej dokumentacji, a Google wprost pisze, że go nie obsługuje.- Adresy koszyka, kasy i konta w przykładzie podmień na te, których używa Twój sklep (sprawdzisz je w ustawieniach stron WooCommerce). Adres mapy witryny zależy od wtyczki SEO.
- Zmiana działa z opóźnieniem. OpenAI i Perplexity piszą o około 24 godzinach. Na przeciążenie, które trwa teraz, robots.txt nie wystarczy.
Bez terminala: jeśli w katalogu strony nie ma pliku robots.txt, WordPress generuje go sam, a popularne wtyczki SEO mają edytor tego pliku w swoich ustawieniach. Możesz też utworzyć plik w menedżerze plików hostingu.
Reguły serwera: kod 429 zamiast blokowania wszystkiego
Kod 429 (Too Many Requests) oznacza „za dużo żądań, zwolnij”. Porządne boty rozumieją go i wracają później. Tak działa też mechanizm ograniczania botów AI w Imunify360: zweryfikowane boty AI dostają umiarkowany limit i odpowiedź 429 z nagłówkiem Retry-After, który mówi, kiedy wrócić, a boty podszywające się pod innych są ograniczane mocniej lub blokowane. Jeśli Twój hosting używa Imunify360, zapytaj wsparcie, czy ta funkcja jest u Ciebie włączona.
Na serwerze Apache możesz sam odesłać kod 429 botom AI, które wchodzą w adresy koszyka i filtrów. Dopisz to w .htaccess nad blokiem # BEGIN WordPress. Pierwszy warunek rozpoznaje bota po nazwie, drugi adres dynamiczny, a reguła odpowiada kodem 429, zanim uruchomi się WordPress:
<IfModule mod_rewrite.c>
RewriteEngine On
RewriteCond %{HTTP_USER_AGENT} (GPTBot|ClaudeBot|Bytespider|meta-externalagent|CCBot) [NC]
RewriteCond %{QUERY_STRING} (^|&)(add-to-cart|filter_[a-z_]+|min_price|max_price|orderby)= [NC]
RewriteRule ^ - [R=429,L]
</IfModule>
Według dokumentacji Apache przy kodzie spoza zakresu przekierowań serwer od razu zwraca podany kod i kończy przetwarzanie. Zwykłe strony produktów te boty nadal widzą.
Na Nginx możesz zrobić prawdziwe ograniczenie tempa. Moduł limit_req nie liczy żądań, dla których klucz jest pusty, więc poniższa konfiguracja ogranicza tylko wymienione boty, a klientów nie dotyka:
# w sekcji http: klucz = nazwa przeglądarki, ale tylko dla wymienionych botów
map $http_user_agent $ai_bot {
    default "";
    ~*(GPTBot|ClaudeBot|Bytespider|meta-externalagent|CCBot) $http_user_agent;
}
limit_req_zone $ai_bot zone=aiboty:10m rate=30r/m;

# w sekcji server lub location /
limit_req zone=aiboty burst=10 nodelay;
limit_req_status 429;
Na hostingu współdzielonym konfiguracji Nginx zwykle nie zmienisz, więc poproś o to wsparcie hostingu, podając nazwy botów i adresy, które Cię obciążają. Przed każdą zmianą w .htaccess zrób kopię pliku: błąd w nim kończy się błędem 500 dla całej strony.
Google opisuje kod 429 lub 503 jako awaryjny sposób na spowolnienie Googlebota, ale nie dłużej niż przez 1–2 dni. Jeśli Googlebot widzi taki kod na tym samym adresie przez kilka dni, adres może wypaść z indeksu. Dlatego Googlebota i Bingbota nie dopisuj do reguł powyżej. Ich wizyty w koszyku ograniczy robots.txt.
Cloudflare i narzędzia hostingu
Jeśli strona stoi za Cloudflare, najprościej zatrzymać boty w warstwie pierwszej. Od lipca 2026 Cloudflare dzieli ruch AI na trzy kategorie: wyszukiwanie, agenty (działające w imieniu użytkownika) i trening, a dla każdej możesz wybrać blokadę na całej stronie, blokadę tylko na stronach z reklamami albo brak blokady. Funkcja jest dostępna także w darmowym planie. Według Cloudflare dla nowych domen od 15 września 2026 boty treningowe i agenty są domyślnie blokowane na stronach z reklamami, a wyszukiwanie pozostaje dozwolone.
Cloudflare zapowiedział, że boty łączące wyszukiwanie z treningiem są objęte regułami blokującymi trening. Po włączeniu takiej reguły sprawdź w analizie ruchu Cloudflare i w Search Console (raport statystyk indeksowania), czy Googlebot i Bingbot nadal wchodzą na stronę bez błędów.
Wiele hostingów ma też własne zapory i przełączniki „blokuj boty”. Działają niezależnie od robots.txt. Jeśli ktoś je kiedyś włączył, mogą odrzucać OAI-SearchBota czy PerplexityBota, mimo że robots.txt je wpuszcza.
Co zrobić z botem, którego widzisz w logu
Czego nie robić
- Nie blokuj Googlebota ani Bingbota, także „na chwilę”. Z Bing korzysta Copilot, a z indeksu Google przeglądy od AI.
- Nie blokuj wszystkiego, co ma w nazwie „bot”. Taka reguła wytnie wyszukiwarki, podglądy linków w komunikatorach i narzędzia, z których sam korzystasz.
- Nie blokuj OAI-SearchBota, jeśli chcesz, żeby ChatGPT polecał Twój sklep. Według OpenAI blokada GPTBota nie usuwa Cię z wyszukiwania ChatGPT.
- Nie blokuj Anthropic po adresach IP, jeśli chcesz tylko wyłączyć trening. Anthropic zaznacza, że blokada IP uniemożliwia mu odczytanie robots.txt, więc nie gwarantuje trwałego wyłączenia. Użyj robots.txt.
- Nie zostawiaj ręcznych blokad bez notatki. Zapisz, co i kiedy dodałeś. Za pół roku nikt nie będzie wiedział, dlaczego sklep zniknął z wyszukiwarki w czacie.
Sklep z akcesoriami na hostingu współdzielonym co noc między 2 a 5 zwalnia do kilkunastu sekund, a hosting przysyła ostrzeżenia o przekroczeniu limitu procesów. Cache stron działa, więc właściciel nie rozumie, skąd obciążenie. Log dostępu pokazuje, że większość nocnego ruchu to dwa boty treningowe chodzące po adresach ?add-to-cart= i kombinacjach filtrów, których cache nie obsługuje. Pomaga reguła 429 dla tych botów na adresach dynamicznych, wpisy w robots.txt i skrócenie listy filtrów. Googlebot i OAI-SearchBot zostają bez zmian, a Search Console przez kolejne tygodnie nie pokazuje spadku indeksowania.
Kiedy nie robić tego samemu
Wpis w robots.txt zrobisz sam w kilka minut. Zleć resztę, gdy:
- sklep pada w trakcie dnia i tracisz zamówienia, a nie masz czasu na analizę logów,
- hosting zagroził zawieszeniem konta za przekraczanie limitów (podobnie jak przy infekcji, zobacz co zrobić, gdy hosting zablokował stronę),
- w logach dominuje ruch z setek adresów IP udających zwykłe przeglądarki, co bardziej przypomina atak niż bota AI,
- nie masz dostępu do logów albo nie wiesz, czy zmiana w
.htaccessczy Cloudflare nie zablokuje wyszukiwarek.
Jeśli w tym samym czasie widzisz dziesiątki nieudanych zamówień na małe kwoty, to nie boty AI, tylko atak opisany w artykule Setki nieudanych zamówień w WooCommerce. A przed szczytem sprzedaży przejdź całą listę kontrolną na Black Friday.
Sklep zwalnia przez boty? Zajmę się tym
W ramach Szybkiej Interwencji (299 zł netto) analizuję logi, ustawiam robots.txt i reguły serwera lub CDN tak, żeby odciążyć sklep bez blokowania wyszukiwarek. W abonamencie Care (199 zł netto miesięcznie) dodatkowo monitoruję stronę, więc nocne przeciążenie zauważę, zanim napiszą klienci.
Najczęstsze pytania
Czy zablokowanie GPTBota usunie moją stronę z ChatGPT?
Nie. Według dokumentacji OpenAI GPTBot zbiera treści do trenowania modeli, a za pokazywanie stron w wyszukiwaniu ChatGPT odpowiada osobny bot OAI-SearchBot. Każdy z nich ustawiasz w robots.txt niezależnie. Jeśli chcesz być widoczny w ChatGPT, nie blokuj OAI-SearchBota.
Czy wystarczy wpis w robots.txt, żeby boty przestały obciążać serwer?
Nie zawsze. Robots.txt to prośba, którą duzi, opisani w dokumentacji operatorzy deklarują respektować, ale nie każdy bot jej słucha, a zmiana działa z opóźnieniem. Gdy serwer jest przeciążony teraz, potrzebna jest reguła na serwerze lub w CDN, która odpowiada kodem 429 albo 403.
Czy blokowanie Google-Extended szkodzi pozycjom w Google?
Według Google nie. Google-Extended to tylko znacznik w robots.txt, a nie osobny robot, i nie wpływa na obecność ani pozycję w wyszukiwarce Google. Ogranicza natomiast wykorzystanie treści do trenowania modeli Gemini i do ugruntowania odpowiedzi w aplikacjach Gemini.
Jak sprawdzić, czy bot podający się za Googlebota jest prawdziwy?
Nazwę bota łatwo podrobić, więc sprawdza się adres IP. Google publikuje listy swoich adresów, a dla Googlebota odwrotne zapytanie DNS powinno zwrócić nazwę w domenie googlebot.com, która z kolei wskazuje ten sam adres IP. Bot, który nie przechodzi tej kontroli, nie jest Googlebotem i można go blokować.
Czy mogę po prostu zablokować wszystkie boty?
Nie rób tego. Zniknąłbyś z Google, Bing, a przez to także z Copilota, oraz z wyszukiwania w ChatGPT i innych czatach. Blokuj lub ograniczaj konkretne boty i konkretne adresy, które generują koszt, a wyszukiwarki zostaw.